
Day 28 算完一次任務的總成本後,PM 把試辦階段的導入報告草稿發給我看,裡面一句話是「複核人員回饋感覺變快了,建議擴大試用」。我問了兩個問題:變快是跟什麼比?品質有沒有跟著掉?PM 答不上來,手上只有 AI 生成時間,沒算複核與返工,也沒有「以前」的對照資料,頂多把 Day 01 那張基準線卡片翻出來充數。但那張卡片任務範圍自選、難度不固定,只寫了「原本完成時間」的粗略描述,拿來比較時間,跟拿不同難度的任務硬比一樣站不住腳。需求書第七節問的「如何量測是否真的縮短撰寫時間、草稿被大幅修改或否決的比例」,答案不能只靠一句主觀印象。
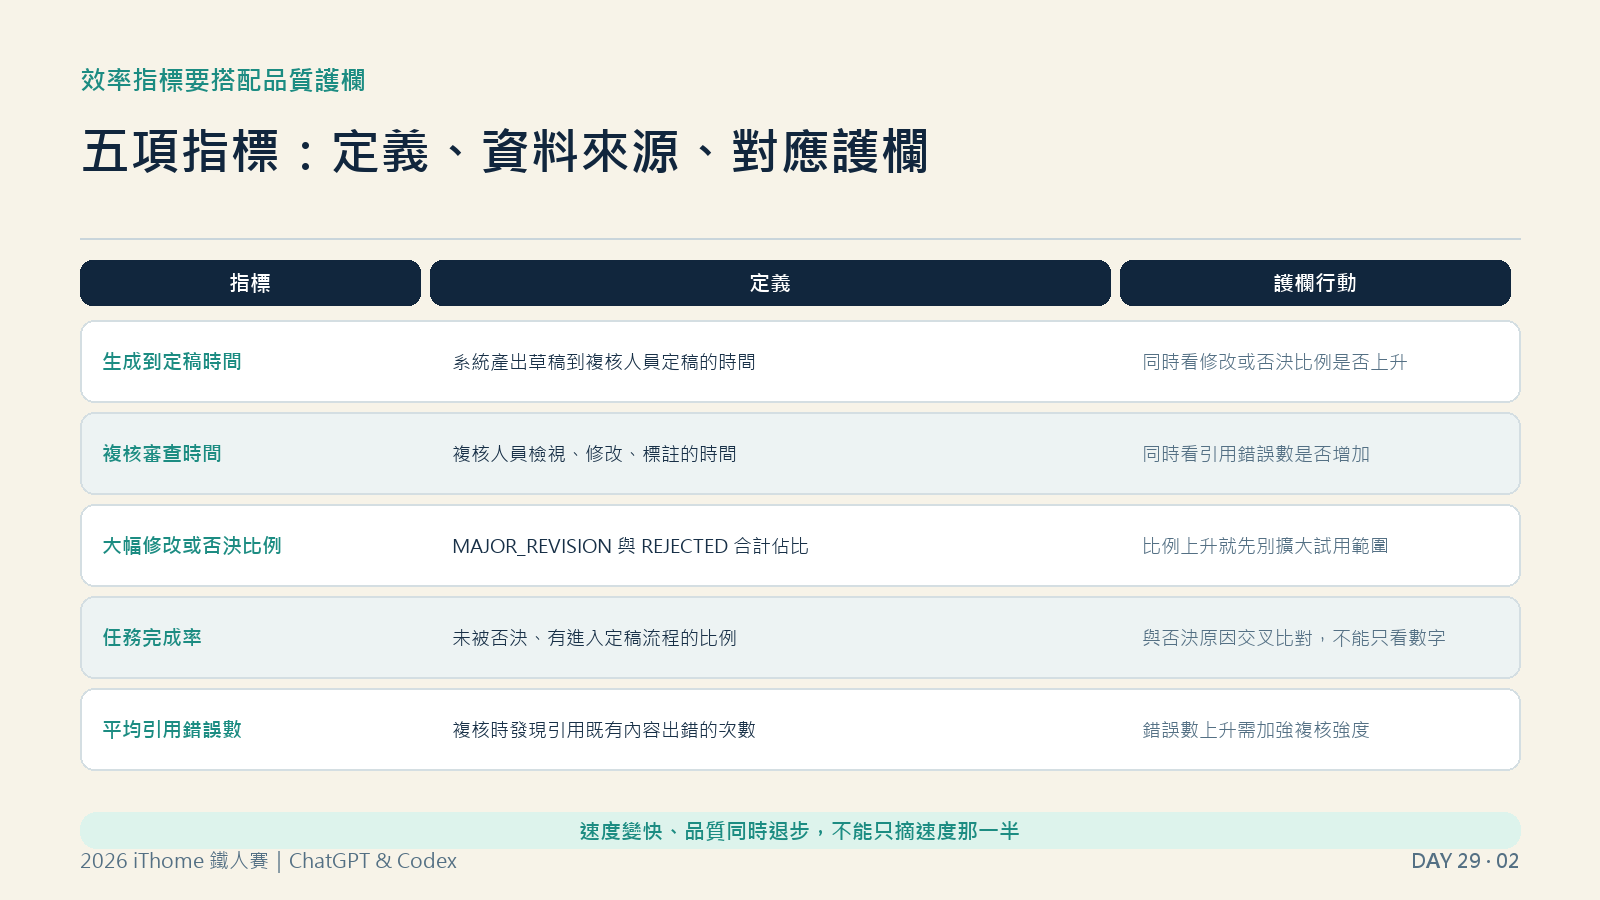
只看效率容易被速度沖昏頭。我把「生成到定稿時間」「複核審查時間」跟「大幅修改或否決比例」「任務完成率」「平均引用錯誤數」放同一張表,後三項是品質護欄——速度變快、護欄跟著惡化,不能只摘速度那一半報告。「大幅修改或否決比例」對應需求書第七節那句話,「平均引用錯誤數」則對應另一題「引用既有內容如何兼顧品質」。
| 指標 | 定義 | 護欄行動 |
|---|---|---|
| 生成到定稿時間 | 系統產出草稿到複核人員定稿的時間 | 同時看修改或否決比例是否上升 |
| 複核審查時間 | 複核人員檢視、修改、標註的時間 | 同時看引用錯誤數是否增加 |
| 大幅修改或否決比例 | 大幅修改與否決兩類合計佔比 | 比例上升就先別擴大試用範圍 |
| 任務完成率 | 未被否決、有進入定稿流程的比例 | 與否決原因交叉比對,不能只看數字 |
| 平均引用錯誤數 | 複核時發現引用既有內容出錯的次數 | 錯誤數上升需加強複核強度 |
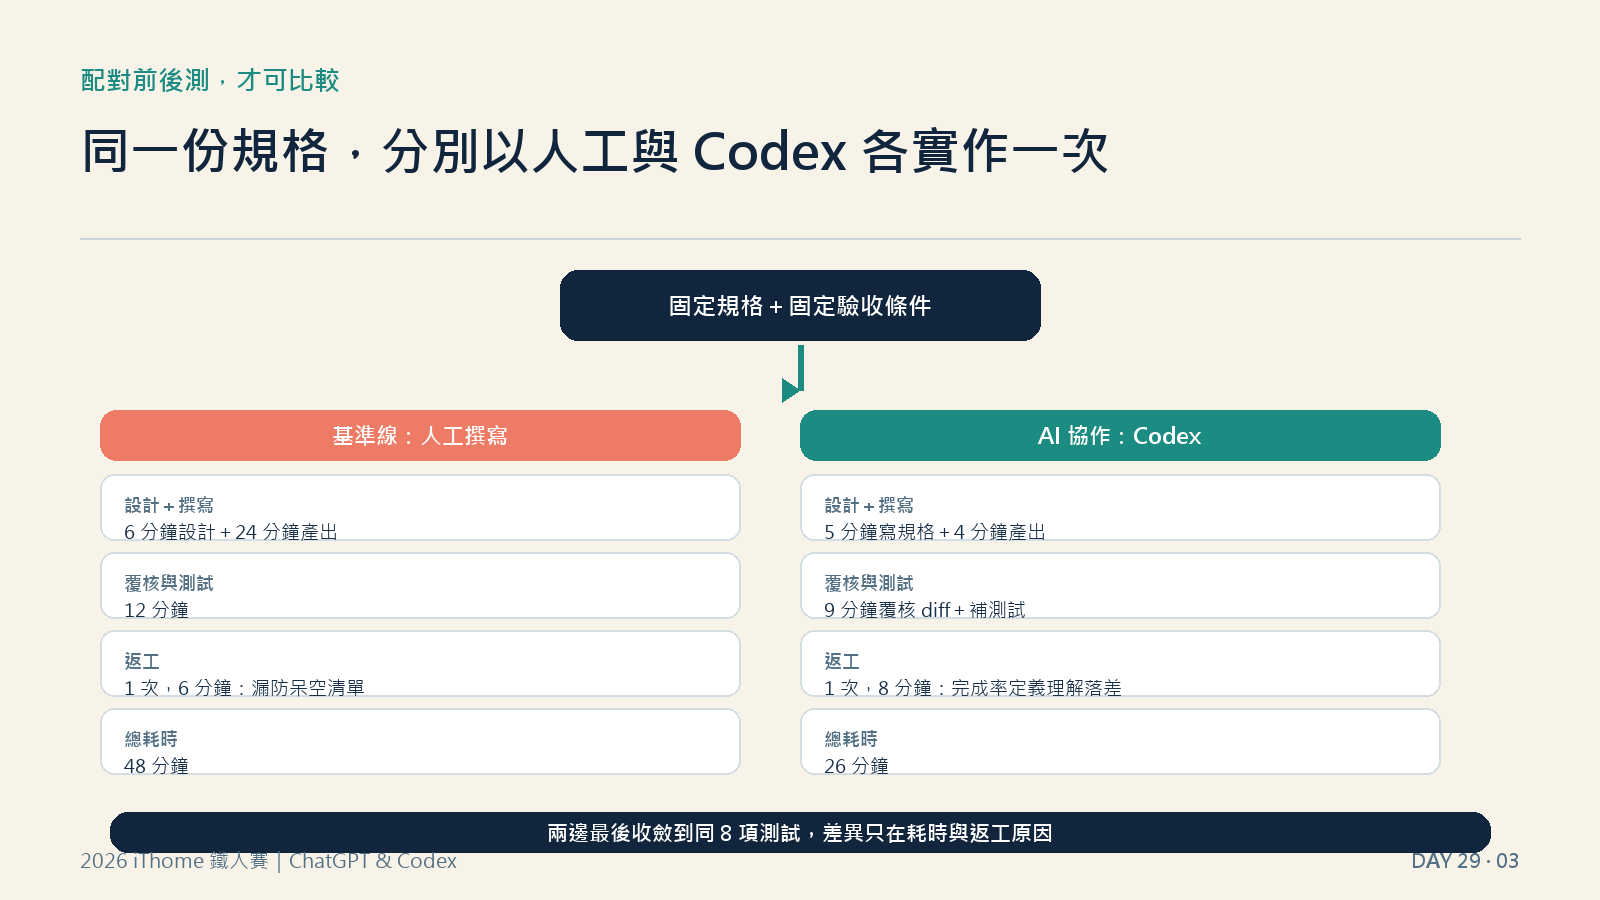
要公平比較「有沒有 AI 協作」,不能拿兩個難度不同的任務硬比,得讓同一份規格跑一次人工、一次 Codex。我選的規格就是今天算指標的工具本身:ReviewMetricsCalculator,把一批複核紀錄彙總成上面五項指標。驗收條件固定:8 項測試全數通過人工覆核、calculate() 對空清單要丟例外,不能算出看似正常卻沒意義的平均值。
public ReviewMetrics calculate(List<ReviewRecord> records) {
    Objects.requireNonNull(records, "records 不能為 null");
    if (records.isEmpty()) {
        throw new IllegalArgumentException("records 不能為空清單,沒有樣本無法計算指標");
    }
    long majorRevisionOrReject = records.stream()
            .filter(r -> r.outcome() == ReviewOutcome.MAJOR_REVISION
                    || r.outcome() == ReviewOutcome.REJECTED)
            .count();
    // 平均值與完成率計算省略,完整版見 ReviewMetricsCalculator.java
    return new ReviewMetrics(/* ... */);
}
人工版花了 48 分鐘,返工原因是漏了空清單防呆,被自己補的測試抓到。Codex 版花了 26 分鐘,返工原因不同:它把「任務完成率」直接定義成「1 減否決率」,漏算「大幅修改後仍算完成」,我補一句需求釐清才修正。兩邊最後收斂到同一份 8 項測試,差異只在耗時與返工原因,測試綠燈不代表理解正確。
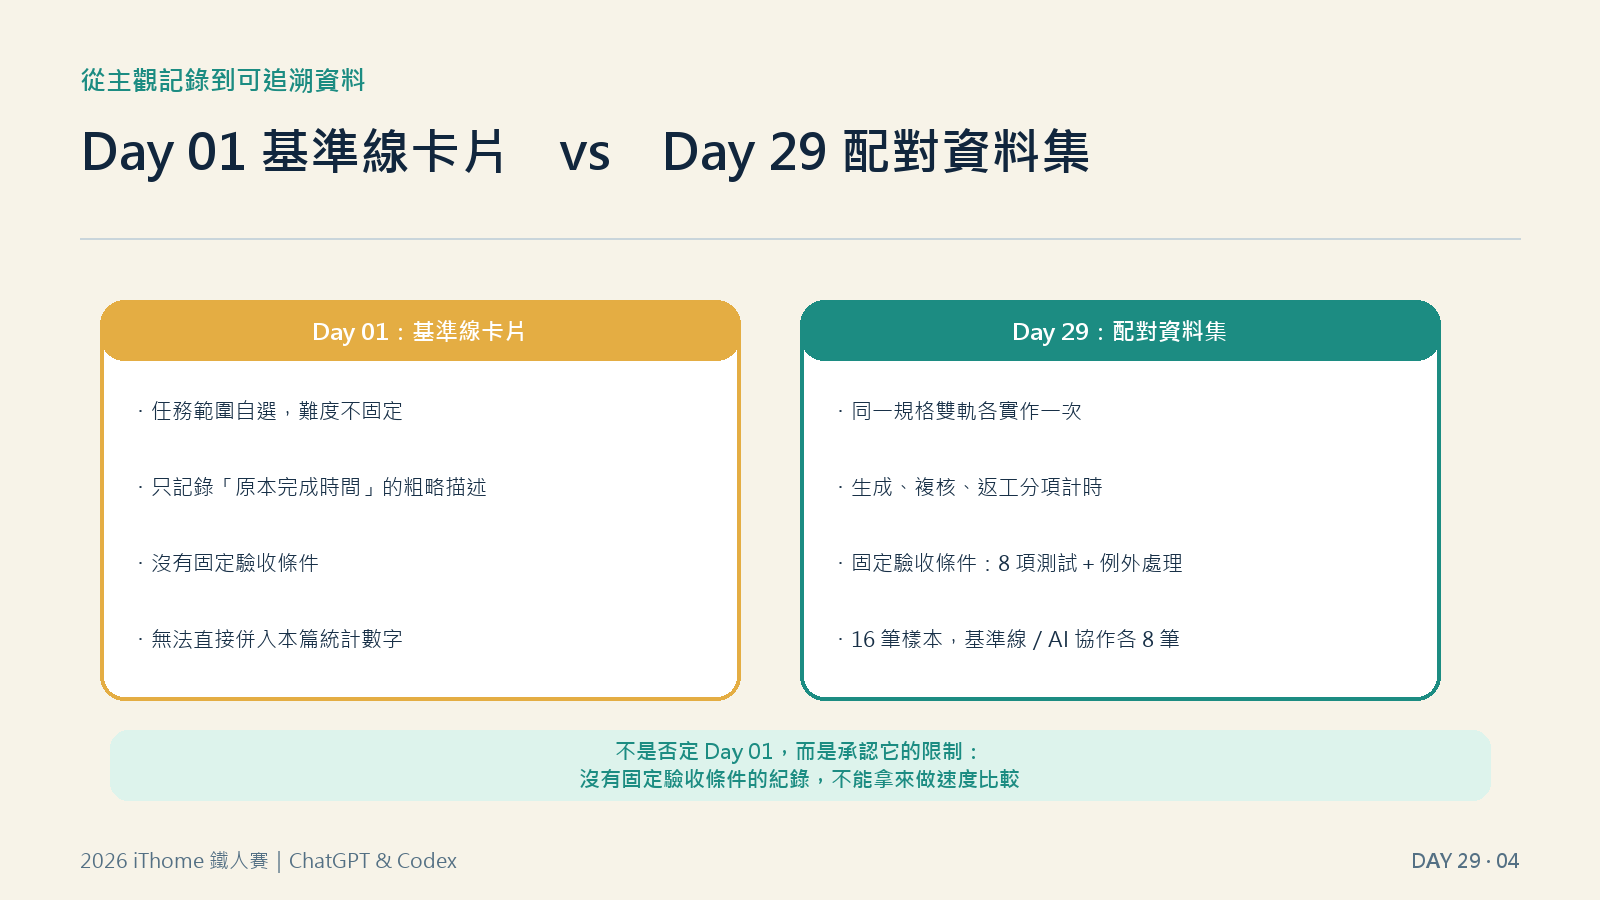
工具寫完,我拿它跑兩批複核紀錄:基準線批次是人工從零撰寫草稿後送複核,AI 協作批次是系統生成草稿後送複核,同類文件、範圍相近,各 8 筆,屬示範規模的小樣本。
| 指標 | 基準線 | AI 協作 | 差異 |
|---|---|---|---|
| 平均生成到定稿時間 | 104.0 分鐘 | 62.0 分鐘 | -42.0 分鐘(約 -40%) |
| 平均複核時間 | 21.1 分鐘 | 28.5 分鐘 | +7.4 分鐘 |
| 大幅修改或否決比例 | 25.0% | 37.5% | +12.5 個百分點 |
| 任務完成率 | 87.5% | 87.5% | 持平 |
| 平均引用錯誤數 | 0.25 | 1.00 | +0.75(為基準線的 4 倍) |
時間少了四成,但複核人員得花更多時間盯著 AI 草稿,修改或否決比例跟著升高,引用錯誤數更翻了近四倍。四格決策規則很單純:兩者都改善就擴大試用,都退步就停止,只提升品質要評估額外時間是否值得,只提升速度則補強複核驗收。這次結果不是全面改善,落在「只提升速度」那格:該先補強複核驗收,不是急著擴大試用範圍。
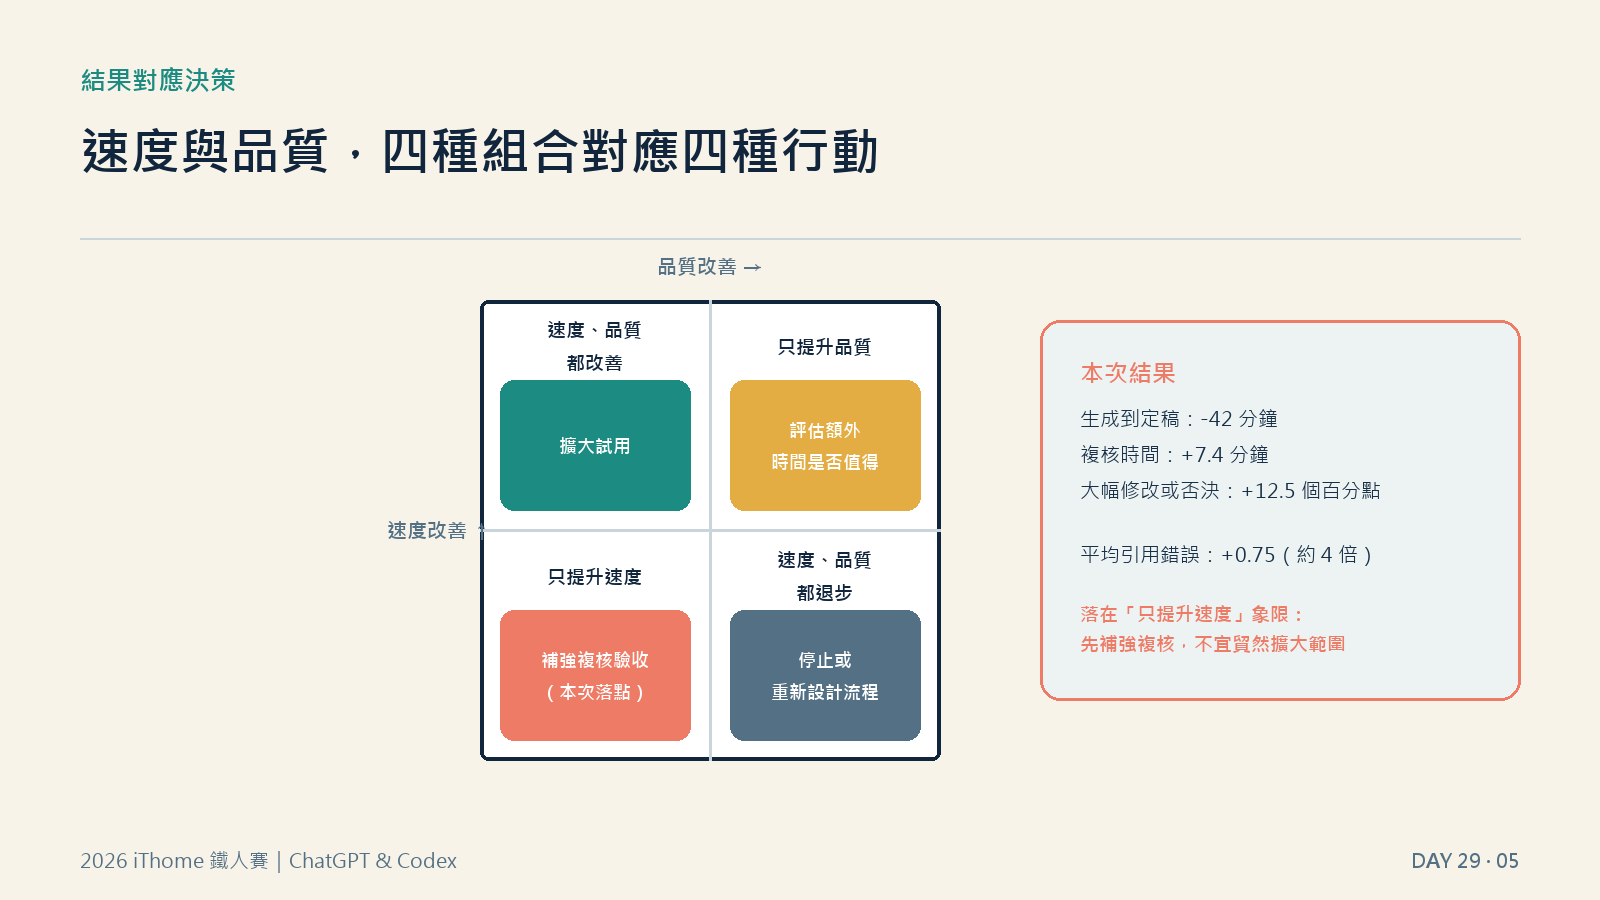
量測的價值是校正「感覺變快了」這類主觀印象,這次資料讓我攔下 PM 那句「建議擴大試用」。但兩批各 8 筆屬示範規模,不足以做統計顯著性檢定;複核人員對 AI 草稿的熟悉度會隨時間改變,資料無法區分是工具效果還是經驗提升;兩批草稿主題相近但非完全相同任務,仍可能有難度落差,只能算相關,不是因果。
配對前後測加一個彙總工具,把「感覺變快了」換成可追溯的數字:速度提升四成,複核負擔、修改否決比例、引用錯誤數卻都變差,落在「補強複核驗收」而非「擴大試用」。Day 30 會回顧整個系列,收斂 AI 與人類能力邊界的心法,也展望 context、skill、Agent 這些能力該怎麼取捨。


 iThome鐵人賽
 看影片追技術